Google kommt endlich auf den neuesten Stand. Die einfachste Lesart nach dem vorläufigen Start von Gemini 4 Argon ist das, was man daraus ableiten kann. Es handelt sich um das neue KI-Modell, das sich auf fortgeschrittene Software-Entwicklungs-Workflows, defensive Cybersicherheit und Datenanalyse fokussiert.
Wie es in letzter Zeit üblich ist, begann die initiale Verteilung erneut stark eingeschränkt für Experten im Bereich der Cyberabwehr über das Fairwind-Programm, mit einer Preisgestaltung von 2 US-Dollar pro Million Eingabe-Tokens und 10 US-Dollar pro Million AusgabewTokens. Es ist offensichtlich, dass Google darauf abzielt, die Distanz zu den neuesten Fortschritten im Reasoning, die von direkten Konkurrenten wie GPT-6 Astra oder Claude Fable 5.1 vorgestellt wurden, zu verkürzen.
Eine Million Ausgabentokens zum bedächtigen Nachdenken
Der erste Punkt, den wir zu diesem neuen Modell hervorheben müssen, ist, dass Google das Fenster für die Generierung von Ausgabetokens auf eine Million erweitert hat, deutlich über dem bisherigen Limit von 64.000 Tokens.
Dieser Spielraum ermöglicht es dem System, hunderte intermediate Deduktionen in einer einzigen Sequenz zu verketten, ohne die Anfrage in mehrere Abschnitte teilen zu müssen. Tatsächlich macht das Unternehmen deutlich, wie wichtig dieser Inferenzeinschnitt ist, besonders wenn es seine Modelle zu wettbewerbsfähigen und wirklich nützlichen Werkzeugen machen will. Und es nennt zwei Beispiele. Mit diesem Spielraum lassen sich komplette Code-Migrationen oder Forschungsmodelle im Finanzbereich angehen, die Dutzende von verknüpften mathematischen Operationen erfordern.
Cara a cara contra GPT-6 Astra y Claude Opus 5.5 en la mesa de pruebas
In den vom Labor bereitgestellten Bewertungen führt Gemini 4 Argon bei spezialisierten Büroarbeiten mit 68,9% im Vals Index gegenüber 63,1% von GPT-6 Astra und 67% von Claude Opus 5.5. Ebenso erzielt das Software-Engineering-Depot DeepSWE v1.1 einen Wert von 77,9% gegenüber 74,1% des OpenAI-Modells.
Dennoch zeigt der Vergleich auch, dass es einen harten Konkurrenzkampf gibt, denn GPT-6 Astra hält die Führung in FrontierSWE v2 mit 65,5% sowie in wissenschaftlichen Tests wie Terminal-Bench Science mit 68,1%.
Bei der autonomen Interaktion mit Desktop-Umgebungen nach dem OSWorld-2.0-Protokoll führt das OpenAI-Modell die Tabelle mit 72,6% an, gefolgt von Google mit 69,2%, während Claude Opus 5.5 die übrige Konkurrenz bei Konsolenbefehlen im Terminal-bench mit 66,4% anführt.
Nicht zu vernachlässigen ist jedoch, dass die Architektur von Google deutliche Vorteile beim Verarbeiten von ultra-extendem Kontext zwischen 256.000 und einer Million Tokens präsentiert und 84,2% bei GraphWalks erreicht, deutlich über dem 71,8% von Astra und dem 66,8% von Opus 5.5.
Vom Rust-Praktikanten zum Speichermanager in der internen Infrastruktur von Google
Bevor der Zugang externen Entwicklern geöffnet wurde, setzten die Google-Ingenieure Argon in der eigenen Infrastruktur ein, um die tatsächlichen Fähigkeiten des Modells aus erster Hand zu prüfen. Und wofür wurden sie dabei fündig?
Laut dem Unternehmen analysierten in Aufgaben zur Optimierung von Rechenzentren Agenten, die auf diesem Modell basieren, die Telemetrie des Systems, um das Speichermanagement neu zu organisieren und über 300 TiB RAM in Produktionsservern freizusetzen. Zudem war das Modell an der Rust-Neucodierung kritischer C++-Bibliotheken beteiligt, wie dem Video-Decodierer libgav1, wodurch eine Leistungssteigerung von 2,7-mal gegenüber der Vorgängerversion erreicht wurde.
Das Dilemma der Cybersicherheit
In der Ankündigung sprach Google auch über Sicherheitsaspekte. Dem Unternehmen zufolge habe es Versionen ohne Schutzmaßnahmen an Organisationen für Analysen wie Wiz im Rahmen seiner Initiative Scan for Good verteilt. Dieser erweiterte Zugang ermöglichte es, kritische Fehler in den Verlaufshistorien medizinischer Krankenhaussoftware zu erkennen, die bisherigen Generationen entgangen waren.
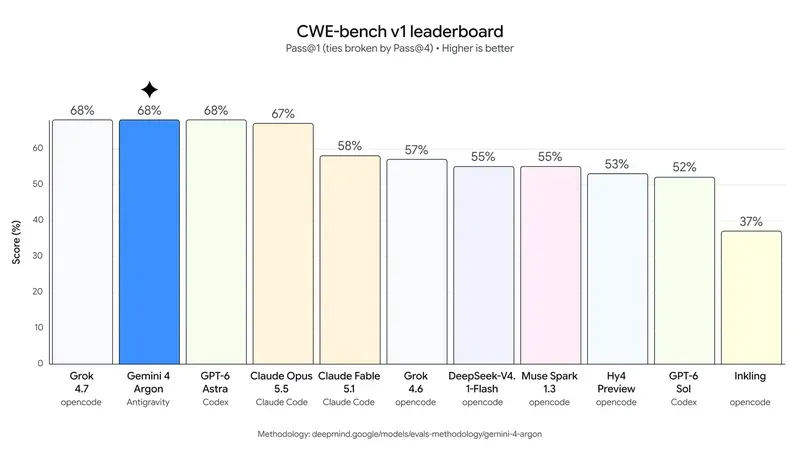
Der Vergleich zeigt ein technisches Unentschieden im CWE-bench v1, wobei sowohl Gemini 4 Argon als auch GPT-6 Astra die Spitzenposition im Sektor mit 68% autonom geminderter Schwachstellen teilen. Interessanterweise ist dieses Unentschieden dreifach, denn Grok 4.7 erscheint ebenfalls auf dem ersten Platz.
Um Risiken vor einer endgültigen Veröffentlichung im Google AI Ultra-Abonnement zu minimieren, hat das Labor die Isolation der Ausführungsumgebungen gegen indirekte Instruktions-Injektionen verstärkt. Auf diese Weise wird die Gedankenkette und die internen Aktivierungen überwacht, um sicherzustellen, dass die Agenten ihr vorgegebenes Ziel nicht aus den Augen verlieren.
Schließlich, in der aktuellen Debatte über die Notwendigkeit, die KI-Entwicklung zu verlangsamen, hat Google dafür plädiert, Transparenz in den logischen Prozessen beizubehalten und die Branchenkonkurrenten dazu aufgefordert, keine undurchsichtigen Techniken zu verwenden, die die Nachvollziehbarkeit der Softwareentscheidungen erschweren. Ein Pfeil, der zweifellos direkt auf OpenAI abzielt.